
制作会社が、自分の会社のコラムを「AIっぽい」と言われた話を書きます。言ったのは社内の人間で、言われたのは私たち、書いた側です。10月1日の夕方、AIっぽいデザインの正体という記事を公開した数時間後に、「コラムのほうも、全部同じに見える」と言われました。
AIっぽさを記事にした当日に、自分の記事がAIっぽいと言われる。これほど恥ずかしい話はないので、本当は書きたくありませんでした。でも、原因を数えてみたら、あなたの会社のブログにも、ほぼ確実に同じことが起きていると分かりました。しかも、世の中に出回っている「AIっぽい文章の見分け方」では、見つからない形で。
「でしょう」を消せばAIっぽさは消える、は間違っていない
AIっぽい文章の見分け方として、よく挙がる特徴があります。「〜と言えるでしょう」「〜が重要です」「〜ではないでしょうか」で終わる文。何でも3つ並べる。太字が多い。どの段落も同じ長さ。締めに展望を語る。
これは正しいです。英語版Wikipediaには、AIが書いた記事を見つけて直すボランティアが集めた兆候のページがあり、中身はほぼこのとおりです。スタンフォード大学の研究チームは2024年、AI分野の国際会議に出された査読文で「称賛に値する」「綿密な」のような形容詞が急に増えたことを手がかりに、査読文の6.5〜16.9%がAIで大きく書き換えられたと推定しました。癖は語に出る。ここまでは本当です。
では、このリストの語を全部消したら、AIっぽさは消えるのか。
消えません。私たちの26本が、その証拠です。「でしょう」で終わる文は、26本に0回。「重要」は26本で1回。「ではないでしょうか」も0回。語尾は言い切りで、固有名詞と数字があり、箇条書きも少ない。リストで採点すれば、人が書いた記事より人らしい点が付きます。それでも「全部同じに見える」と言われた。
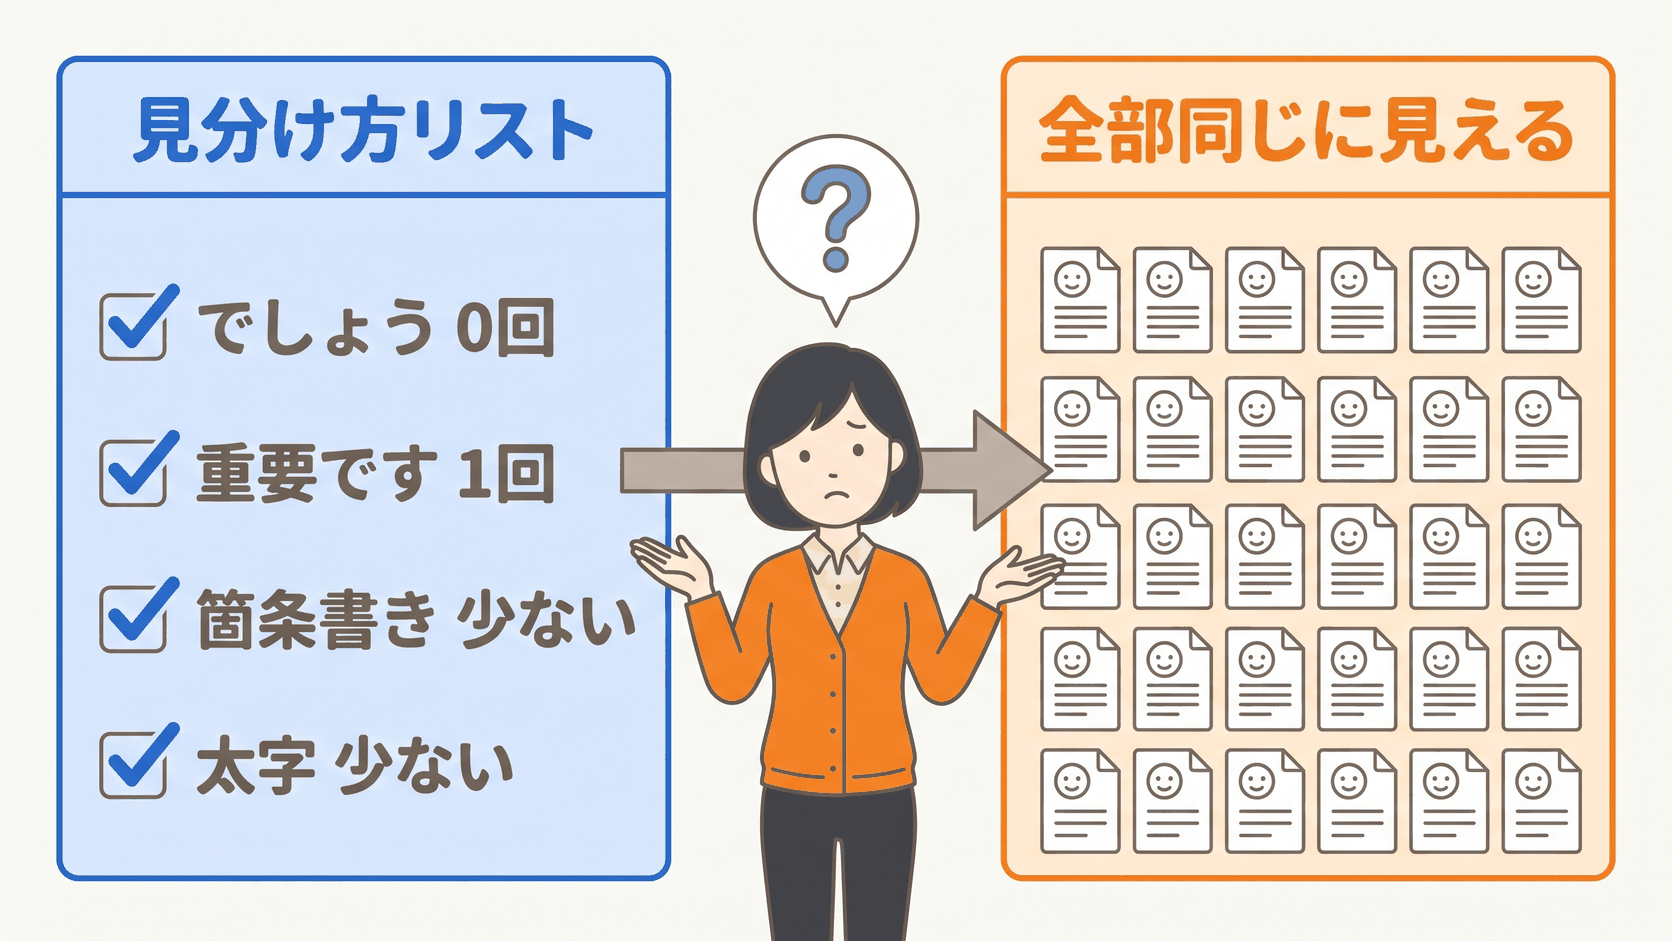
ここで、リストに載っていないことを言います。リストに載っている語は、世の中のAI文章に共通した癖です。でも、1つの会社のブログに溜まる癖は、その会社だけのものです。それはリストには載っていません。自分の原稿を並べて数えないと、見えません。
9月10日の夜、2時間23分で25本
まず、数える前に白状しておきます。
26本の原稿の更新時刻を見ると、25本が9月10日の21時08分41秒から23時31分51秒の間に入っています。2時間23分。残りの1本が、10月1日のデザインの記事です。
書く前に、よく読まれている書き手の記事を分析した手順書を作ってありました。「言い切る」「文を短く」「抽象語を避け、固有名詞と数字を入れる」「反対意見を認めてから書く」「弱い部分を先に出す」。1本に使えば、読みやすくなる指示です。私たちはそれを、25本に、同じ晩に、同じ強さで当てました。
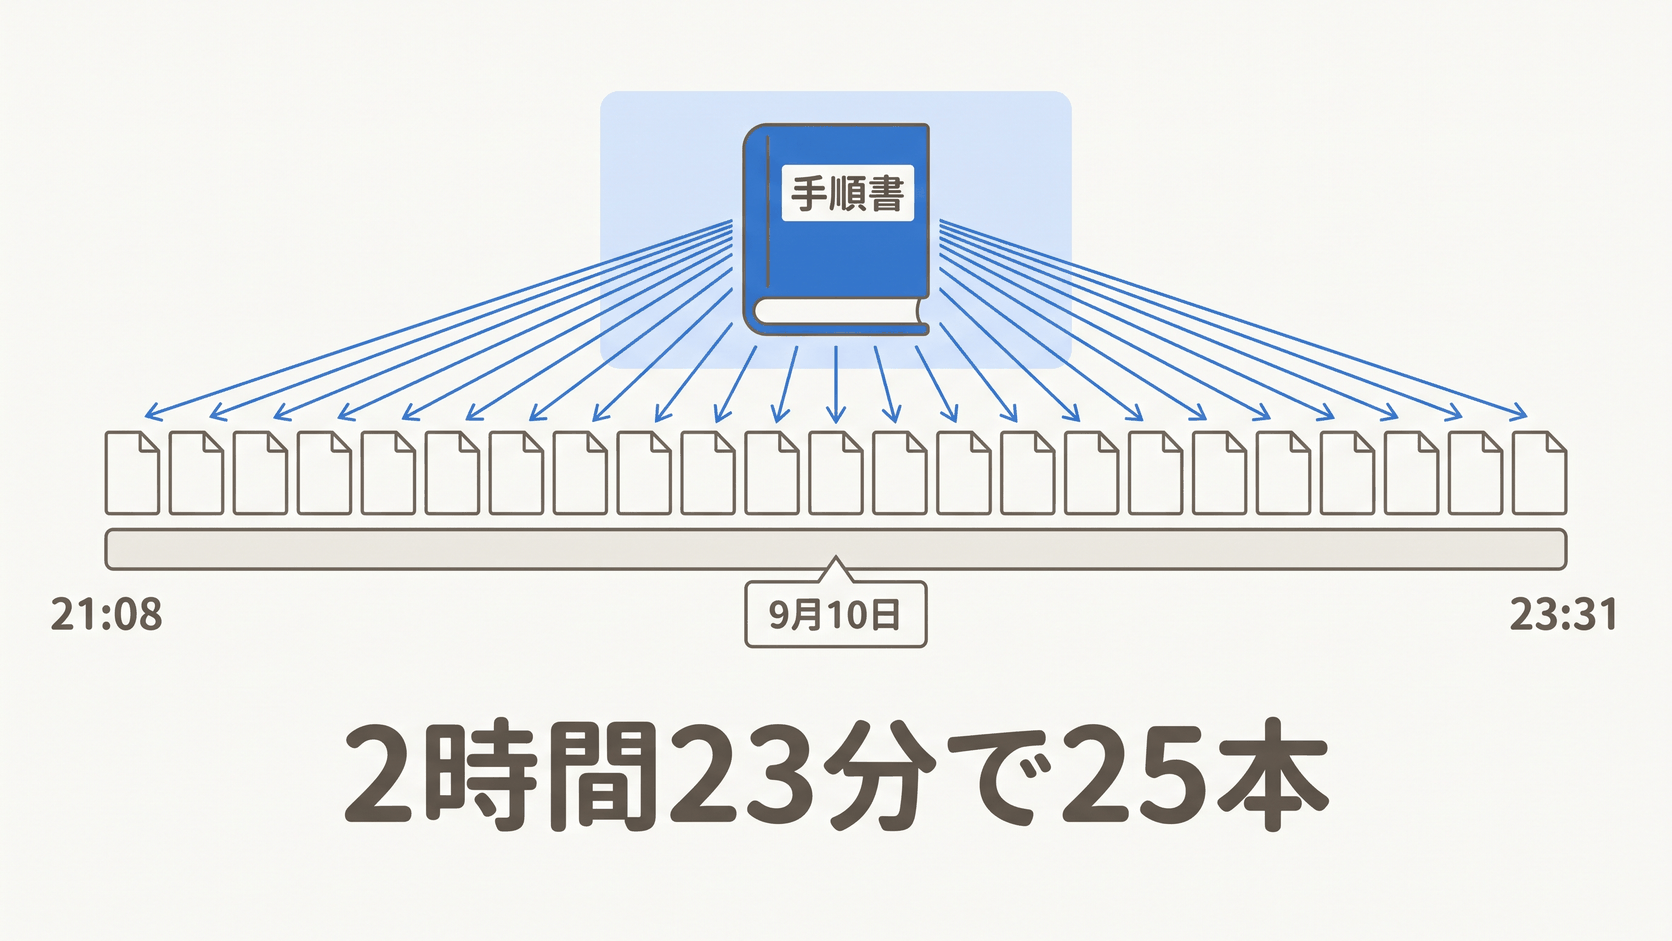
1本ずつ読めば、どれも読みやすい。読み手は1本しか読まないのだから、それでいいと思っていました。違いました。社内の人間は、26本を続けて読んだのです。あなたの会社のブログも、採用の候補者や取引先の担当者は、何本か続けて読みます。
1文ずつは自然に読める、5つの文
何が同じに見えたのか。26本から5つの文を引きます。すべて、公開済みか予約済みの原稿にそのまま載っている文です。
- 「ブレーキは、壊れたら効く側に作ってください。」(AIに社内ツールを作らせた記録)
- 「3社の見積書を並べると、たいてい項目の切り方が3社とも違います。」(見積書の書かれていない3行)
- 「正直に書くと、返信は続きません。」(MEOの順位を追う前に直すべき3つ)
- 「AIは、決めていない部分を、いちばん速く、いちばんきれいに平均で埋めるだけです。」(AIっぽいデザインの正体)
- 「決めていなければ、AIは全部に答えます。」(問い合わせ対応AIの2本の線)
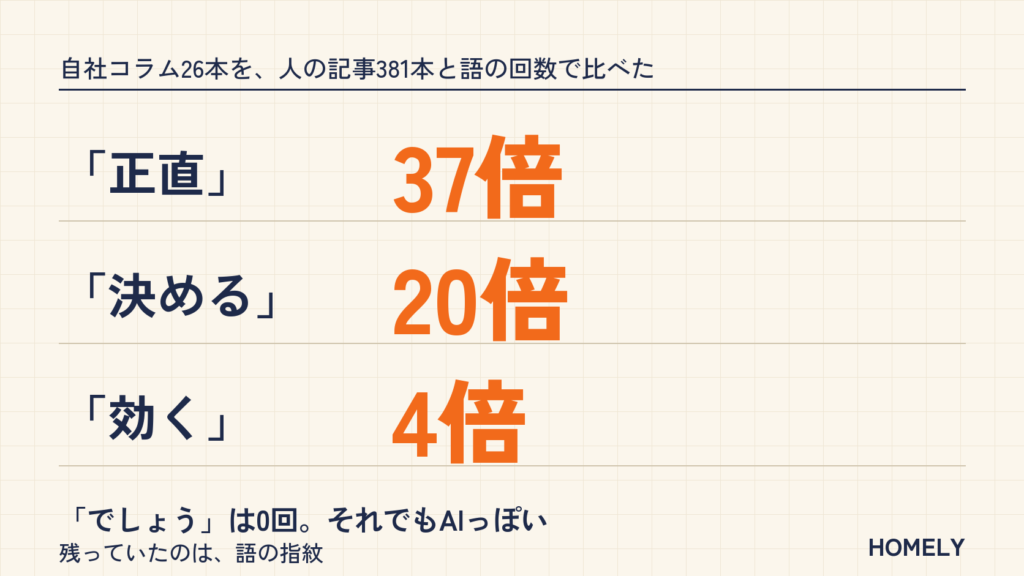
5文を並べると、同じ手だと分かります。「効く」「たいてい」「正直に」「いちばん」「決める」。この5語を、26本の中で数えました。比較相手は、個人で書いて読まれているマーケティング系の書き手3人の公開記事381本、約209万字。両方を1万字あたりの回数にしています。
| 語 | 自社26本 | 人の381本 | 倍率 | 出てくる本数 |
|---|---|---|---|---|
| 正直(に) | 4.92回 | 0.13回 | 37倍 | 26本中23本 |
| たいてい | 1.26回 | 0.06回 | 23倍 | 11本 |
| 半分 | 4.92回 | 0.24回 | 21倍 | 26本 |
| 決める | 12.59回 | 0.65回 | 20倍 | 20本 |
| 無い(漢字で) | 4.01回 | 0.33回 | 12倍 | 19本 |
| 効く | 2.75回 | 0.65回 | 4倍 | 9本 |
| いちばん・一番 | 3.66回 | 1.04回 | 3.5倍 | 10本 |
「正直(に)」は、26本中23本に出ます。「たいてい」は、人が381本で12回しか使わない語を、私たちは26本で11回。「効く」は4倍と小さく見えますが、人の記事では381本中50本にしか出ない語が、26本中9本に出ています。1本の中では1回か2回。だから本人は気づかない。並べて数えて、はじめて見えます。
そして、多い語の裏には、少なすぎる語があります。
| 語 | 自社26本 | 人の381本 | 倍率 |
|---|---|---|---|
| でしょう | 0回 | 5.75回 | 0 |
| と思います | 0.11回 | 3.49回 | 0.03倍 |
| 重要 | 0.11回 | 2.01回 | 0.1倍 |
| 最も | 0.11回 | 1.76回 | 0.1倍 |
| 効果 | 0.92回 | 2.86回 | 0.3倍 |
| 本音・ぶっちゃけ | 0回 | 0.28回 | 0 |
2つの表は、裏表です。「でしょう」を避けろという指示を守ると、全部の文が言い切りになる。言い切りが続くと、書いている側も息が詰まる。そこで、断定を和らげる語に手が伸びます。「正直に書くと」「たいてい」「半分正しい」。和らげ方まで手順書で揃っていたから、25本が同じ語で和らげました。「重要」を避けると「いちばん」に手が伸び、「効果がある」が抽象的だから「効く」に寄る。避けた語の穴を、別の1語で埋めた跡です。
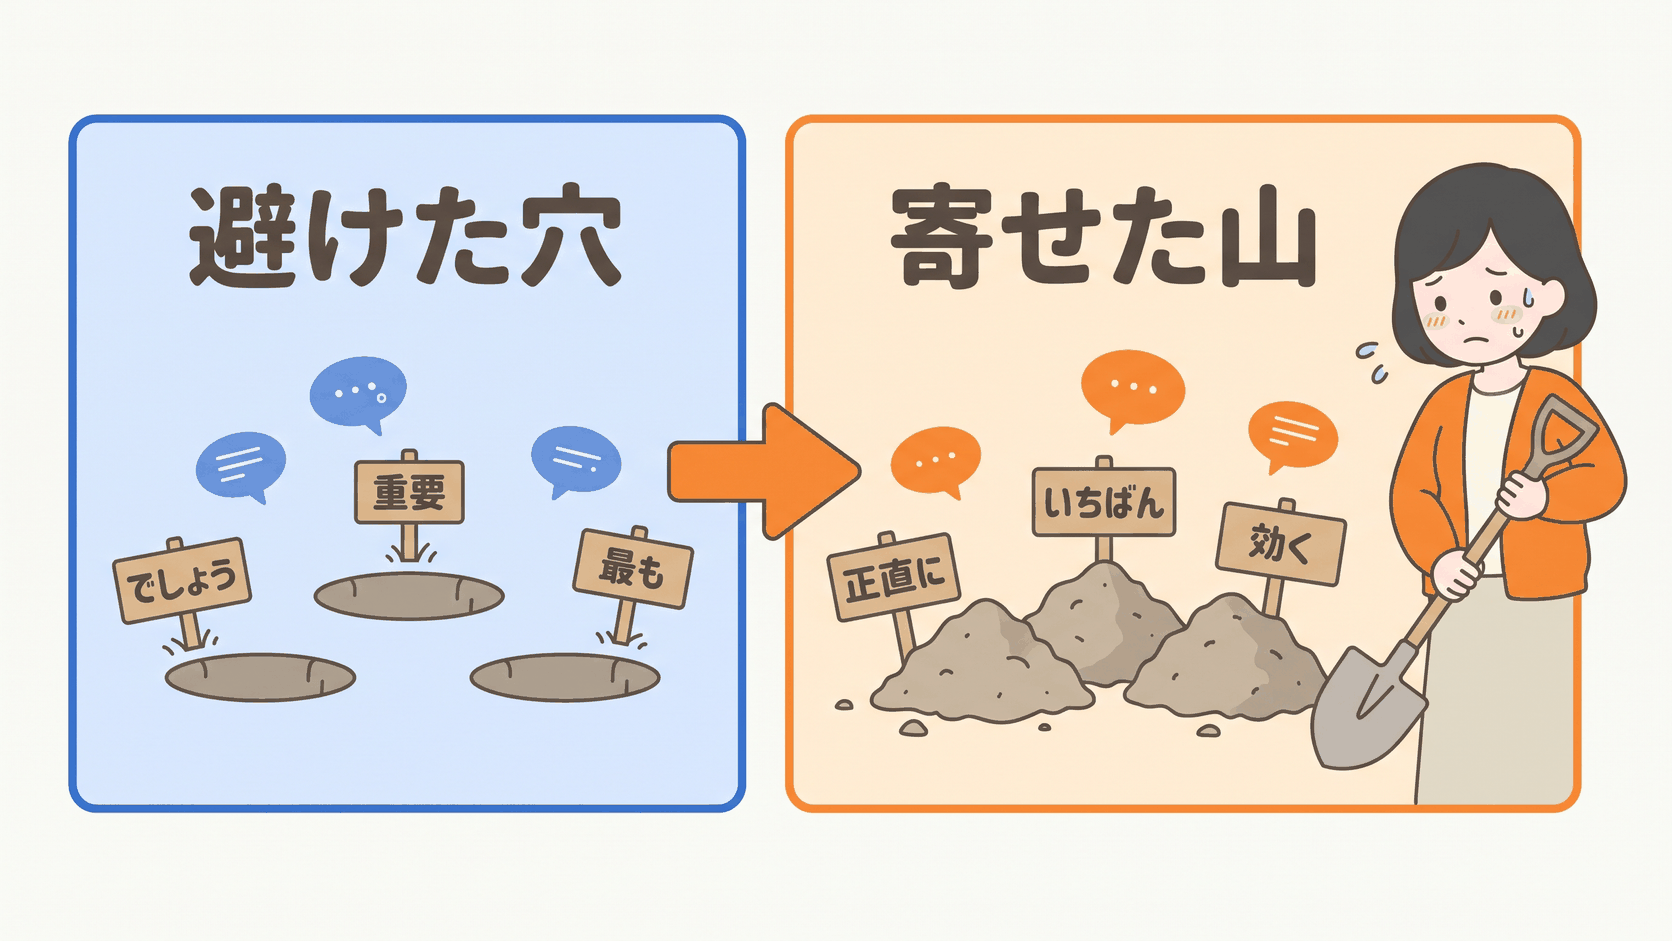
デザインの記事で、私たちはAIっぽさを「誰も決めていない部分が平均で埋まった跡」と呼びました。文章のAIっぽさは、その逆です。決めすぎた跡。同じ指示を同じ強さで守り続けた、その几帳面さが指紋になります。
60年前、著者不明の論文12篇を「upon」で当てた統計学者
指紋で書き手を当てる方法には、60年以上の歴史があります。
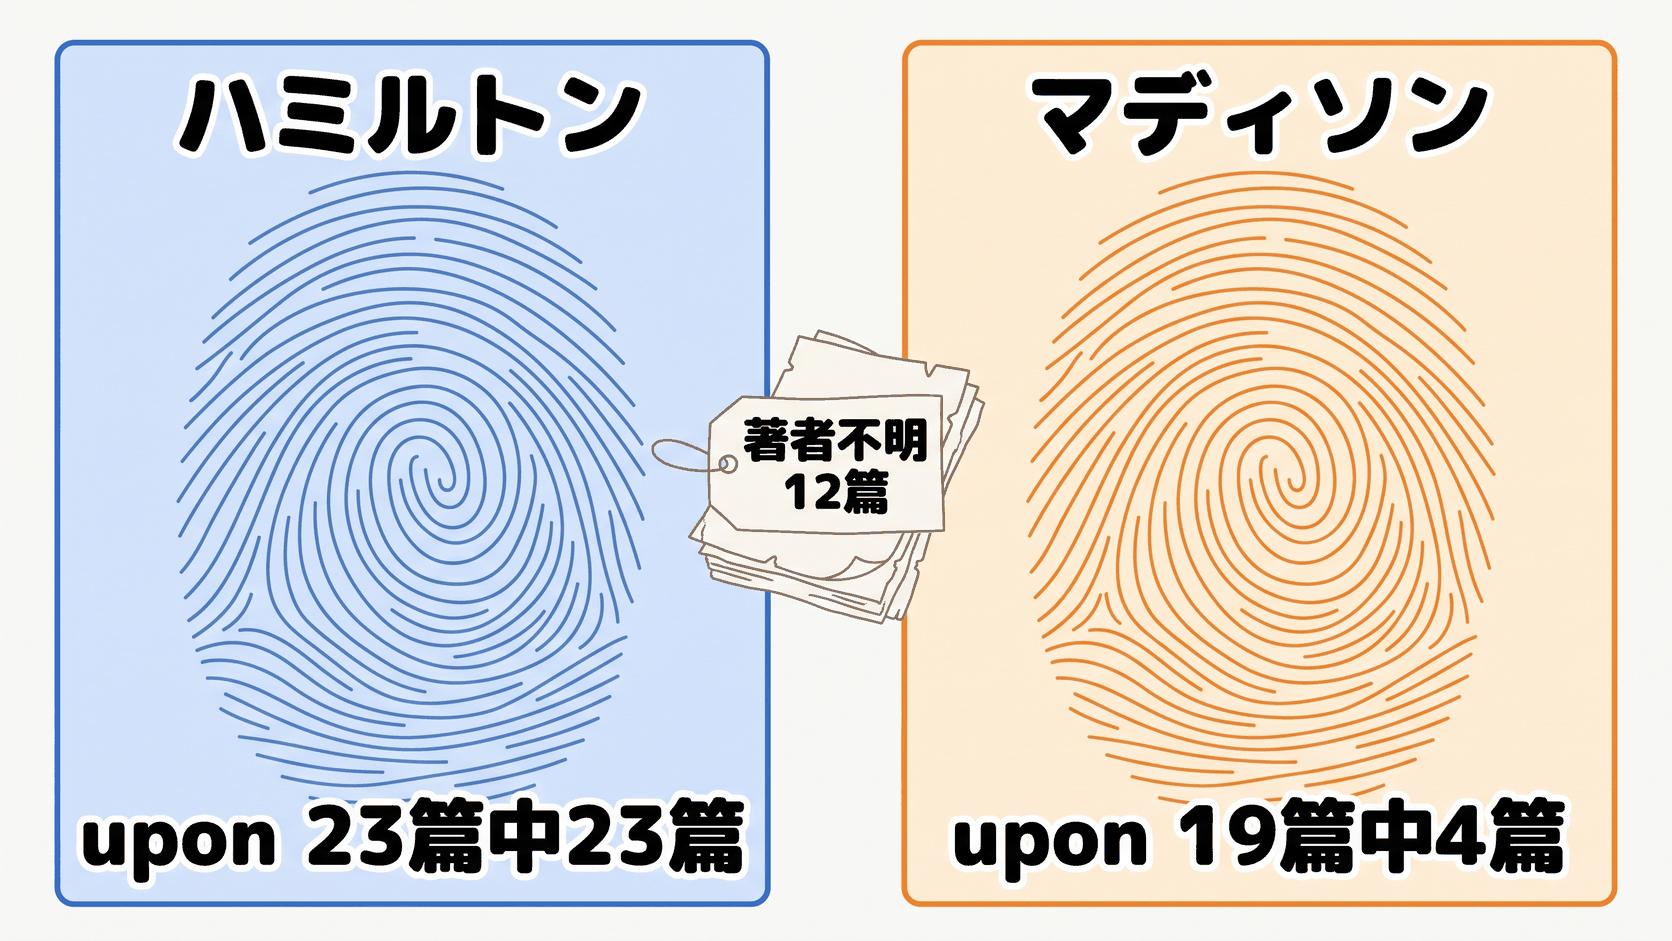
統計学者のフレデリック・モステラーとデビッド・ウォレスは、アメリカ建国期の論文集「ザ・フェデラリスト」のうち、ハミルトンとマディソンのどちらが書いたか分からないままだった12篇の著者を、語の回数で判定しました。手がかりにしたのは、中身を運ぶ語ではありません。uponのような、何を書くときにも使う語です。ハミルトンと分かっている23篇はすべてuponを一定以上の頻度で使い、マディソンの19篇でその頻度に達するのは4篇。結論は、12篇ともマディソンでした。
日本語でも同じです。2023年にPLoS ONEに載ったZaitsuとJinの研究は、人が書いた日本語の文章72本と、GPT-3.5とGPT-4が書いた文章を、助詞や接続詞のような機能語の使い方だけで98.1%、ほかの文体の特徴を加えると100%の精度で見分けました。2026年3月の言語処理学会年次大会では、国立情報学研究所の林美佐氏と相澤彰子氏が、同じ質問への回答をGPT-5.2、Claude Sonnet 4.5、Gemini 3 Proに書かせ、どれが書いたかを98.2%で当てられると報告しています。人かAIか、ではありません。どのAIかまで、語の指紋で分かる。
指紋は、書いた本人には見えません。見えないから、型を変えても残る。10月1日に私たちは書き出しと締めと見出しの型を変え、今朝、その書き方で流出が続く個人情報の記事を公開しました。午後に数えたら、「止める」が1万字あたり7.4回。人の記事は0.1回。68倍。顔は変えられても、指紋は残っていました。
私たちが1段落を書き直した、その前と後
では、どうするか。消しゴムで消すように語を消しても、別の語が穴を埋めるだけです。やったのは、1段落ずつ、指紋の語を「その場で起きていること」の言葉に戻す作業でした。
9月10日に書いた中小企業のAI活用の原稿から、指紋の語が5つ入った段落を、そのまま引きます。
ただし正直に書くと、全部を任せる勇気はありませんでした。運用を始めるにあたって線を引いています。プラグインの更新や数行のガード処理のような軽微な修正は、バックアップと構文チェックと表示確認を通した上で自動で適用する。WordPress本体のファイルの改変や原因が特定できないケースは、修正案を人に提案するだけで止める。ピン工場で言えば、18工程を全部機械に渡したのではなく、機械に向く工程だけを渡した形です。
「正直に」「任せる」「止める」「ではなく」「渡す」。書き直すと、こうなります。
全部を自動にする勇気は、ありませんでした。だから線を引いています。プラグインの更新や数行のガード処理のような軽い修正は、バックアップと構文チェックと表示確認を通してから自動で当てる。WordPress本体のファイルに手を入れる修正と、原因がはっきりしない不具合は、修正案を人に見せるところまでで、適用はしない。ピン工場で言えば、18工程のうち機械に向く工程だけを機械に回した形です。
中身は1つも変えていません。線の引き方も、18工程も、ピン工場も同じです。変えたのは、前置きの「正直に」を消して弱い部分をそのまま書いたこと。「任せる」「止める」「渡す」を、自動にする、適用はしない、機械に回す、という実際の動作に戻したこと。それだけで、文章から「いつもの手」が抜けます。
白状すると、書き直した段落にも別の癖があります。「だから」が増えました。指紋は消えません。薄くはできます。
| 指紋の語 | 代わりにやること | 上限 |
|---|---|---|
| 正直に(37倍) | 前置きを消し、弱い部分そのものを1文で書く | 1本に1回 |
| たいてい(23倍) | 何件中何件かを数字で書く。数字が無ければ書かない | 0回 |
| 半分(21倍) | 反対意見のどこが合っていて、どこから違うかを書く | 1本に1回 |
| 決める(20倍) | 誰が、何を、いつ決めたか。「判断する」「選ぶ」も使う | 1本に3回 |
| 効く(4倍) | 何に、どれだけ効いたかを数字で。「効果」も使う | 1本に1回 |
| いちばん・一番(3.5倍) | 「最も」も使う。順位なら数字で | 1本に2回 |
| でしょう・と思います(0) | 推測の文には推測の印を付ける。全部は言い切らない | 下限を付ける。10文に1文 |
上限の数字は、私たちの26本から逆算したものです。大事なのは0にしないこと。「でしょう」を0にしたから、「正直に」が37倍になりました。
あなたの会社のブログで、今夜やること
ここまで読んで、「うちはAIに書かせていないから関係ない」と思った方へ。関係あります。同じ人が、同じ手順で、同じ月に何本も書けば、同じ指紋が付きます。AIを使っているかどうかは、指紋の濃さを変えるだけです。
やることは3つで、今夜で終わります。
- 直近10本の本文を、1つのテキストにまとめる。1本では指紋になりません。2万字あれば十分です
- 「この人の文章は人らしい」と思う書き手の公開記事を、同じ量だけ用意する。比べる相手がいないと、何倍かが出ません
- 動詞と副詞の回数を、1万字あたりで両方出す。形態素解析はMeCabやjanome(無料)。10語に絞るなら、エディタの検索で1語ずつ数えても30分です
自分の側が10倍を超えた語と、相手の1割以下しか出ない語を書き出せば、それがあなたの会社の指紋です。上の2つの表と同じ形になります。
この原稿も、書き終えてから同じ数え方で見ました。「数える」8回。題材なので、これは仕方がありません。「直す」2回、「残る」2回、「決める」1回。「正直」「たいてい」「半分」「効く」「いちばん」は、表と引用とかぎかっこの中にしか出てきません。「でしょう」は、この次の1文で、26本ぶんの初めての1回を使います。
あなたの会社のブログは、誰が読んでも「いつもの手」が見える文章になっていないでしょうか。直近の原稿を10本お送りいただければ、同じスクリプトで指紋を取り、上の2つの表の形でお返しします。→ お問い合わせ
出典
- Wikipedia:Signs of AI writing(WikiProject AI Cleanup) https://en.wikipedia.org/wiki/Wikipedia:Signs_of_AI_writing
- Liang, W. ほか「Monitoring AI-Modified Content at Scale: A Case Study on the Impact of ChatGPT on AI Conference Peer Reviews」ICML 2024 https://proceedings.mlr.press/v235/liang24b.html
- Mosteller, F. & Wallace, D. L.『Inference and Disputed Authorship: The Federalist』1964/The Harvard Crimson「Statistician Identifies Federalist Authors」1959-12-10 https://www.thecrimson.com/article/1959/12/10/statistician-identifies-federalist-authors-pa-statistical/
- Zaitsu, W. & Jin, M.「Distinguishing ChatGPT(-3.5, -4)-generated and human-written papers through Japanese stylometric analysis」PLoS ONE 2023 https://doi.org/10.1371/journal.pone.0288453
- 林美佐・相澤彰子「LLMによる日本語生成におけるモデル固有表現パターンの分析」言語処理学会第32回年次大会(2026年3月) https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/B9-17.pdf
- 自社コラム原稿26本(87,362字)と、公開記事381本(2,086,114字)の語の回数の比較(2026-10-07、HOMELY)
